
Die meisten Unternehmen haben ein Mandat für agentische KI und einen unveränderten Headcount. Die Engineers, die es umsetzen könnten, sind bereits verplant, und die Kapazität muss aus Arbeit freigesetzt werden, die die Organisation heute leistet. Die meisten IT-Serviceteams sind mit genau dieser Arbeit bereits überlastet.
Dieser Artikel behandelt, wo diese Kapazität derzeit gebunden ist, warum Effizienzprogramme sie selten freisetzen, was ein Integrationsausfall über IT-Stunden hinaus kostet, wie Sie messen, was in Ihrer Organisation tatsächlich feststeckt, und welche Maßnahmen Kapazität erzeugen, die über den nächsten Planungszyklus hinaus hält.
Kernaussagen
- Durch Effizienz erzeugte Kapazität wird wieder aufgesogen, weil das Team die Arbeit weiterhin besitzt. Durch Übertragung der Verantwortung erzeugte Kapazität kommt nicht zurück.
- IT-Teams verbringen laut MuleSofts Umfrage 2026 unter 1.050 IT-Verantwortlichen 36 % ihrer Zeit mit individueller Integrationsarbeit, während der angebundene Anteil der Anwendungslandschaft im Jahresvergleich von 29 % auf 27 % fiel.
- In derselben Studie nennen 82 % der IT-Verantwortlichen Datenintegration als großes Hindernis für die Einführung von KI. Die Arbeit, die Kapazität verbraucht, ist auch die Arbeit, die das Ergebnis blockiert.
- Integrationsausfälle kosten mehr als IT-Stunden. Solange ein Flow ausgefallen ist, steht der Geschäftsprozess, den er trägt, und diese Störung erscheint nie in der Budgetposition für Integration.
- Stunden unterschätzen das Problem. Integrationswartung ist unterbrechungsgetrieben, und Unterbrechungen zerstören die zusammenhängenden Blöcke, in denen agentische und architektonische Arbeit stattfindet.
Das Betriebsmodell hinter Managed Integration Services beschreibt das Integration Ops Buch ausführlich: Lifecycle-Phasen, Ownership-Muster und Playbook-Beispiele. Kostenlos herunterladen.
Was bedeutet Kapazität für KI eigentlich?
Kapazität für KI ist die Verfügbarkeit von Engineers, die verstehen, wie sich die Systeme der Organisation in der Produktion verhalten, in Zeitblöcken, die lang genug sind, um autonomes Verhalten sicher zu entwerfen und zu testen. Sie ist eine Funktion davon, wer frei ist, welche Fähigkeiten diese Personen haben und wie oft sie unterbrochen werden. Headcount allein beschreibt sie nicht, weshalb Organisationen mit stabiler IT-Besetzung trotzdem berichten, niemanden für agentische Arbeit verfügbar zu haben.
Die Unterscheidung zählt, weil die drei Komponenten unabhängig voneinander versagen. Eine Organisation kann freie Leute mit dem falschen Wissen haben, die richtigen Leute ohne ununterbrochene Zeit oder die richtigen Leute vollständig damit beschäftigt, bestehende Services am Laufen zu halten. Jeder Fall erfordert eine andere Maßnahme, und nur einer der drei wird durch Einstellungen gelöst.
Warum Effizienzprogramme keine Kapazität freisetzen
Maßnahmen fallen in zwei Klassen, und sie verhalten sich über einen Planungszyklus unterschiedlich. Beide lohnen sich; nur eine davon zeigt sich in der Ressourcenplanung des nächsten Jahres.
Effizienzmaßnahmen machen dasselbe Team schneller bei Arbeit, die es weiterhin besitzt. Besseres Tooling, Workflow-Automatisierung, ein KI-Coding-Assistent, eine Low-Code-Plattform. Der Gewinn ist real und anfangs messbar. Er erodiert auch, weil Ownership Nachfrage erzeugt: Das Team, das einen Service besitzt, absorbiert jede Anfrage, die dieser Service erzeugt, und die freigewordenen Stunden füllen sich aus dem Backlog, der bereits da war.
Ownership-Maßnahmen entfernen die Arbeit aus der Verantwortung des Teams. Jemand außerhalb des Teams überwacht sie, hält den Eskalationspfad und steht unter einer Servicezusage für das Ergebnis ein. Die Stunden kommen nicht zurück, weil der Mechanismus, der sie früher zurückholte, nicht mehr auf Ihr Team zeigt.
Der praktische Test ist eine einzige Frage. Wer wird nach der Änderung angerufen, wenn es bricht? Wenn die Antwort weiterhin Ihre Engineers einschließt, ist die Kapazität nur geliehen.
Wir haben an anderer Stelle argumentiert, dass zusätzlicher Headcount die Skalierung von IT-Services nicht löst, weil Wissenstransfer- und Koordinationskosten schneller wachsen als das Team. Dieser Artikel behandelt die schärfere 2026er-Version des Problems. Woher kommt Kapazität für eine tatsächlich neue Klasse von Arbeit, wenn niemand eingestellt wird?
Wo die Kapazität derzeit gebunden ist
MuleSofts Connectivity Benchmark Report 2026, basierend auf 1.050 IT-Verantwortlichen weltweit, beziffert Integration auf 36 % der IT-Zeit, die für Design, Bau und Test individueller Integrationen aufgewendet wird. Die Ausgabe 2025 derselben Studie meldete 39 %.
Diese Zahlen decken nur die Build-Phase ab. Unsere Position: Design, Bau und Test sind ein Bruchteil der Gesamtkosten einer Integration über ihre Lebensdauer. Der Rest kommt nach dem Go-live, wenn die Verbindung einen laufenden Geschäftsprozess trägt und jeder Ausfall Arbeit weit über das IT-Team hinaus unterbricht.
Der Trend unter den Zahlen ist der andere nützliche Teil.
Die Landschaft wuchs um rund 7 %, während der angebundene Anteil sank. Der Zeitaufwand bewegte sich kaum. Eine Organisation in dieser Lage rennt, um auf der Stelle zu bleiben, und die verdrängte Arbeit ist das, was sie als Nächstes beginnen wollte.
ONEiOs eigene Forschung zum Stand der Integrationslösungen zeigt von der Lieferseite in dieselbe Richtung, mit Ressourcenengpässen als einer der Hauptursachen für Verzögerungen bei Integrationsprojekten. Der Engpass sind Menschen, und das schon seit einiger Zeit.
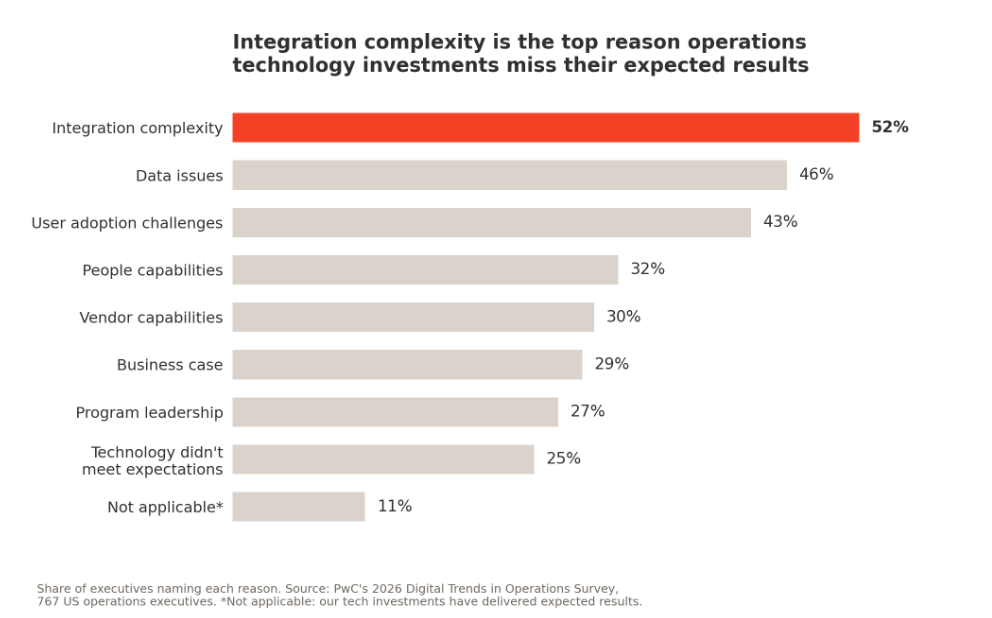
PwCs Digital Trends in Operations Survey 2026 zeigt von der Käuferseite in dieselbe Richtung: Von 767 US-Operations-Führungskräften, deren Technologieinvestitionen nicht vollständig geliefert haben, nennen 52 % Integrationskomplexität als Hauptgrund, vor Datenproblemen und Nutzerakzeptanz.
Die Kapazität, die Sie brauchen, hat eine bestimmte Form
Kapazität wird meist so diskutiert, als wären Engineers austauschbare Einheiten. Für agentische Arbeit sind sie das nicht.
Ein Agent, der über Systeme hinweg handelt, braucht jemanden, der Datenverträge, Systemsemantik, Ausfallarten und das Verhalten jeder angebundenen Plattform unter Produktionslast versteht. Dieses Wissen ist ungleich verteilt, und es konzentriert sich in einer Gruppe: den Menschen, die die Verbindungen warten. Integrationswartung ist die einzige Rolle, die verlangt, jedes System gleichzeitig zu kennen, weil ein defekter Flow überall entlang der Kette entstehen kann.
Gartners Forschung vom April 2026 zu KI in Infrastruktur und Betrieb fand, dass 38 % der I&O-Verantwortlichen mit Rückschlägen anhaltende Kompetenzlücken nannten, wobei nur 28 % der KI-Anwendungsfälle die ROI-Erwartungen vollständig erfüllten. In vielen Organisationen existieren diese Fähigkeiten bereits im Haus, vollständig damit beschäftigt, die aktuelle Landschaft am Laufen zu halten.
Das hat eine direkte Planungskonsequenz. Kapazität aus dem First-Line-Support freizusetzen erzeugt Stunden. Kapazität aus der Integrationswartung freizusetzen erzeugt genau die Menschen, die einen Agenten sicher machen können. Die beiden sind keine Substitute.
Einen vollständigeren Blick darauf, was Agenten von der Ebene unter ihnen brauchen, bietet unsere Analyse dazu, was sich ändert, wenn KI-Agenten in Ihre Integrationsebene einziehen.
Messen Sie Unterbrechungen, nicht Stunden
Eine Zeiterfassung, die sechs Stunden im Monat für Integrationssupport zeigt, sieht handhabbar aus. Sie ist irreführend, und Googles SRE-Praxis erklärt, warum.
Google deckelt operative Routinearbeit per Richtlinie bei 50 % der Zeit eines SRE, und die eigenen Quartalsumfragen melden im Durchschnitt etwa 33 %, mit einer Spanne von 0 % bis 80 % über die einzelnen Personen. Zwei Befunde lassen sich auf jede IT-Organisation übertragen. Gebundene Kapazität sitzt in bestimmten Personen, sodass ein Organisationsdurchschnitt wenig darüber sagt, wer verfügbar ist. Und die Hauptquelle dieser Routinearbeit sind Unterbrechungen.
Integrationswartung ist von Natur aus unterbrechungsförmig. Ein Partner ändert ein Feld. Ein Zertifikat läuft ab. Eine Synchronisation stoppt ohne Alarm und fällt Tage später auf, wenn zwei Systeme unterschiedliche Zahlen zeigen. Manche davon sind für sich genommen ernste Incidents, und selbst die kleinen erfordern die Person, die die ganze Kette versteht.
Die Kosten bleiben nicht in der IT. Solange ein Flow ausgefallen ist, steht der Prozess, den er trägt: Bestellungen warten, Tickets bleiben liegen, ein Partner oder Kunde ist betroffen, und jede an den Prozess gekoppelte Servicezusage ist gefährdet. Sechs Stunden in der IT-Zeiterfassung können weit mehr verlorene Zeit in der gesamten Organisation bedeuten, nirgends budgetiert, und alles Geld, das stattdessen die KI-Initiative finanzieren könnte.
Innerhalb des Teams beseitigen sechs Stunden, verteilt auf fünfzehn Unterbrechungen, jeden Block, der lang genug für Designarbeit wäre. Einen Agenten zu bauen, der sicher über mehrere Systeme hinweg handelt, ist keine Aufgabe, die zwischen Eskalationen passt.
Die Landschaft wuchs um rund 7 %, während der angebundene Anteil sank. Der Zeitaufwand bewegte sich kaum. Eine Organisation in dieser Lage rennt, um auf der Stelle zu bleiben, und die verdrängte Arbeit ist das, was sie als Nächstes beginnen wollte.
ONEiOs eigene Forschung zum Stand der Integrationslösungen zeigt von der Lieferseite in dieselbe Richtung, mit Ressourcenengpässen als einer der Hauptursachen für Verzögerungen bei Integrationsprojekten. Der Engpass sind Menschen, und das schon seit einiger Zeit.
PwCs Digital Trends in Operations Survey 2026 zeigt von der Käuferseite in dieselbe Richtung: Von 767 US-Operations-Führungskräften, deren Technologieinvestitionen nicht vollständig geliefert haben, nennen 52 % Integrationskomplexität als Hauptgrund, vor Datenproblemen und Nutzerakzeptanz.
Die letzte Spalte ist diejenige, die die Zeilen trennt. Drei der vier Ansätze lassen die Verantwortung, wo sie war, und deshalb ist die Kapazität, die sie erzeugen, nur vorläufig.
Wo ein Managed Integration Service hineinpasst
Ein Managed Integration Service übernimmt die Verantwortung für die Verbindungen selbst, einschließlich Monitoring, Incident Response, Änderung und dem an jede Verbindung gekoppelten Service Level. Der Anbieter steht auf dem Eskalationspfad.
Für ein Kapazitätsprogramm ist der Effekt konkret. Das Unterbrechungsvolumen sinkt, weil Ausfälle außerhalb des internen Teams erkannt und behandelt werden. Die Engineers, die das meiste Systemwissen hielten, werden in zusammenhängenden Blöcken verfügbar. Die Geschäftsprozesse, die auf diesen Verbindungen laufen, absorbieren keine ungeplanten Ausfallzeiten mehr. Und die Integrationslandschaft blockiert die agentische Arbeit nicht mehr, weil Verbindungen mit einer Zusage betrieben werden, von jemandem, dessen Aufgabe es ist, sie zu überwachen.
„Unbeeindruckt. Ich glaube, das ist es, was sich für uns geändert hat ... wir nutzen unsere Zeit für andere Dinge, um andere Dinge zu überwachen statt der Datenaustausche." So beschreibt Dmitri von der Stadt Espoo, wie die Veränderung aus dem Inneren des Teams aussieht.
Wann das nicht die richtige Wahl ist. Wenn Ihre Integrationslandschaft klein, stabil und intern ist, ist die Unterbrechungslast bereits gering und es gibt wenig Kapazität freizusetzen. Wenn Ihre Engineers tatsächlich frei sind und der begrenzende Faktor Fähigkeiten sind, adressieren Schulung oder Einstellung das direkter. Und wenn Integration Ihr Differenzierungsmerkmal ist, ist es eine vernünftige strategische Entscheidung, die Fähigkeit im Haus zu behalten. Der Fall wird stärker mit der Größe der Landschaft, der Zahl der beteiligten externen Parteien und der Änderungsrate der angebundenen Systeme.
Fazit zur Kapazität für KI
In den meisten Organisationen existiert die Kapazität für KI bereits. Sie ist dafür verplant, eine wachsende, teilweise angebundene Anwendungslandschaft am Laufen zu halten, und die Organisation bezahlt diese Verplanung zweimal: einmal in Engineering-Stunden und noch einmal in der Störung, die jeder Ausfall in den Prozessen verursacht, die diese Verbindungen tragen.
Zwei Dinge folgen daraus. Effizienzprogramme werden die Kapazität nicht freisetzen, weil das Team die Verantwortung behält, die die Stunden zurückholt. Und der Pool, den es zuerst anzugehen lohnt, ist die Integrationswartung, weil sie sowohl den größten Anteil der Engineering-Zeit als auch die spezifischen Menschen hält, deren Systemwissen agentische Arbeit sicher macht.
Beginnen Sie mit Messen. Führen Sie das Kapazitätsbuch einen Monat lang für Ihre Senior Engineers und sehen Sie sich die dritte Spalte an. Wenn der längste ununterbrochene Block im Monat unter einem halben Tag liegt, wartet die KI-Initiative auf Kapazität, nicht auf Budget oder Fähigkeiten.
Nicht sicher, wo Ihre Integrationsebene steht? Das Integration Ops Reifegrad-Assessment gibt Ihnen eine strukturierte Einschätzung zu Ownership, Monitoring und Change-Bereitschaft in Ihrer gesamten Systemlandschaft.